
Après publication: combien de temps avant les premiers signaux de visibilité dans Google et les moteurs IA ?
Dernière mise à jour le 7 septembre 2026 à 18:45
En bref:
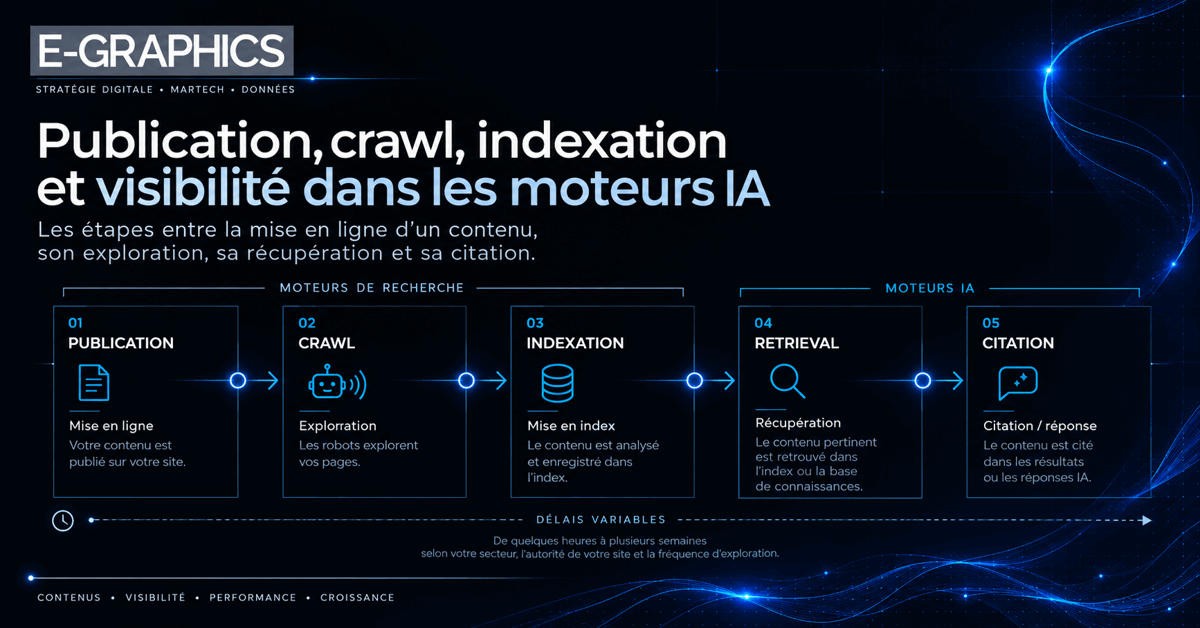
- Publier ne rend pas visible de manière instantanée. Découverte, indexation, association sémantique, retrieval (récupération par les moteurs de recherches) (récupération) et citation (attribution par l’intelligence artificielle) sont cinq mécanismes distincts, dotés de délais et de critères différents.
- Les premiers jours après publication mesurent l’accès à l’information. Un crawl rapide ne démontre ni pertinence ni autorité, et une absence de signal à J+3 ne démontre aucun échec éditorial. La performance se mesure sur le moyen et le long terme.
- Un moteur de réponse connecté au Web peut utiliser une page aujourd’hui sans l’avoir intégrée à ses données d’entraînement. Retrieval (récupération) et entraînement systèmes d’intelligence artificielle relèvent de deux logiques séparées.
- La question utile porte sur la persistance de la bonne association plutôt que sur le volume: 30 jours d’observation, 90 jours de signal, 180 jours de tendance stratégique.
Publier une nouvelle page donne une impression trompeuse d’immédiateté. Pour l’entreprise, le changement est instantané: l’article existe, son URL fonctionne, le sitemap peut être actualisé et les premiers liens internes sont déjà en place. Le travail semble être fini.
Mais pour les moteurs, plusieurs processus commencent. La page doit être découverte, explorée, interprétée, éventuellement indexée, puis rapprochée de sujets et de requêtes. Un moteur de réponse utilisant le Web doit ensuite déterminer si ce contenu mérite d’être récupéré (retrieval) lorsqu’une question correspondante lui est posée. Une éventuelle citation (attribution) ajoute encore une autre étape: le moteur doit non seulement trouver la page, mais aussi comprendre suffisamment bien son sujet, son auteur ou son organisation pour l’utiliser dans le bon contexte.
Ces mécanismes n’avancent ni à la même vitesse ni selon les mêmes critères.
C’est ce qui rend la question « combien de temps faut-il pour devenir visible ? » beaucoup moins simple qu’elle n’en a l’air. Quelques jours peuvent suffire pour constater un crawl. Plusieurs semaines sont parfois nécessaires avant d’observer des associations intéressantes. Une compréhension plus stable du positionnement éditorial se juge plutôt sur la persistance.
Confondre ces horizons conduit à une pratique fréquente: modifier une page avant même d’avoir laissé aux systèmes le temps de produire un signal interprétable.
Une publication crée d’abord une nouvelle surface à interpréter
Google documente cette première étape avec une prudence assez nette. L’exploration d’une nouvelle URL peut demander plusieurs jours et une demande de nouvelle exploration ne garantit ni une inclusion immédiate dans l’index ni une position dans les résultats.
Cette distinction change la lecture des premiers jours. Ainsi, une page publiée vendredi qui ne génère aucun signal exploitable le lundi n’a pas encore démontré son échec. Le moteur peut simplement ne pas avoir terminé sa découverte, son exploration ou son traitement.
L’inverse vaut également. Une URL crawlée rapidement n’a pas encore acquis une position éditoriale ou commerciale. Elle a été juste visitée.
Le crawl prouve l’accès et ne prouve ni la pertinence, ni l’autorité, ni la compréhension.
La visibilité numérique se construit sur plusieurs niveaux
La confusion vient souvent de l’utilisation du mot « visibilité » pour décrire des phénomènes très différents. Le tableau suivant montre quelques niveaux de base.
| Niveau | Ce qui se passe | Ce que l’entreprise peut raisonnablement en déduire |
|---|---|---|
| Découverte / crawl | Le moteur trouve et visite l’URL | La surface est techniquement accessible et détectée |
| Indexation / association | Le contenu est intégré à un index et rapproché de sujets, entités ou requêtes | Le moteur commence à lui attribuer un contexte |
| Retrieval (récupération) | Le moteur compare le sens de la question à celui des contenus disponibles et extrait les passages les plus proches | Un passage précis a été jugé pertinent dans ce contexte particulier |
| Reconstruction | Le moteur relie correctement le contenu, l’organisation, les concepts et leurs relations | Le corpus commence à produire une compréhension cohérente de l’entreprise et de son territoire |
| Citation (attribution) | Le système garde la trace des passages utilisés et les rattache explicitement aux phrases produites | Une affirmation de la réponse a été rattachée à la page, pour cette formulation et à cet instant |
Ces niveaux ne constituent pas un tunnel automatique. Ainsi, une page peut être indexée sans jamais apparaître pour une question commercialement intéressante. Une autre peut être retrouvée pour une requête très précise sans renforcer encore la compréhension globale de l’entreprise.
Une citation ponctuelle par un moteur IA ne signifie pas davantage qu’une nouvelle autorité a été acquise. Elle démontre d’abord que, pour une question donnée et dans les conditions du moment, le système a considéré cette source comme utilisable.
Glossaire: retrieval (récupération) et citation (attribution)
Ces deux termes reviennent dans tout ce qui suit et sont régulièrement confondus. Le retrieval (récupération) trouve les informations pertinentes dans une base de connaissances, tandis que la citation associe ces sources directement aux phrases générées par le modèle. Les deux étapes forment la base des systèmes modernes de type RAG (Retrieval-Augmented Generation). [1] [2] [3]
Le retrieval (la récupération)
- Définition: processus qui cherche et extrait les documents ou les passages de texte les plus proches de la question posée.
- Fonctionnement: il convertit les textes en représentations mathématiques (vecteurs) pour comparer le sens de la requête avec celui de la base de connaissances.
- Rôle: il fournit au modèle de langage la matière première exacte pour répondre sans avoir à inventer. [4] [3] [1]
La citation (l’attribution)
- Définition: action de lier une affirmation précise de la réponse finale au texte source d’origine. [5]
- Fonctionnement: le système garde la trace des fragments de texte utilisés lors du retrieval et les affiche sous forme de notes ou de liens dans l’interface. [6] [3]
- Rôle: elle permet de vérifier les faits, d’éviter les fausses informations (hallucinations) et de renforcer la fiabilité de l’outil. [3]
La distinction a une conséquence directe pour une entreprise qui publie. Être récupérable demande un contenu dont le sujet est explicite et le vocabulaire proche de la question réelle. Être citable demande en plus une source stable, attribuable à une organisation identifiable, dont un passage précis peut être isolé et rattaché à une affirmation. Une page peut donc être récupérée sans jamais être citée, et c’est exactement ce que montrent les niveaux décrits plus haut.
Sources du glossaire:
- ExplainX, définitions de citation et de retrieval
- Zilliz, génération augmentée par récupération et citations
- Explication vidéo, retrieval et citation dans un dispositif RAG
- Explication vidéo, recherche vectorielle et récupération de passages
- ZeroEntropy, extraction de citations
- Tensorlake, citations dans un dispositif RAG
Retrieval et entraînement des modèles LLM répondent à deux logiques différentes
La formulation « attendre que les LLMs prennent le contenu » entretient une confusion supplémentaire.
Un moteur de réponse connecté au Web n’a pas besoin d’avoir intégré une page dans ses données d’entraînement pour pouvoir l’utiliser aujourd’hui.
OpenAI indique qu’un site public peut apparaître dans ChatGPT Search lorsque son crawler de recherche est autorisé à y accéder. Cela concerne la découverte et l’utilisation du contenu dans la recherche actuelle. L’entraînement futur d’un modèle relève d’un processus différent.
Pour une entreprise qui publie aujourd’hui, l’enjeu immédiat est donc beaucoup plus concret:
- la page doit être techniquement accessible ;
- son sujet doit être suffisamment explicite ;
- ses relations avec les autres contenus du site doivent être intelligibles ;
- l’organisation ou l’auteur doit être identifiable ;
- le contenu doit pouvoir être retrouvé lorsqu’une question pertinente apparaît ;
- et la source doit offrir suffisamment de valeur pour être préférée à d’autres documents disponibles.
Cette architecture peut produire des effets de retrieval (récupération) bien avant qu’un nouvel entraînement général d’un modèle n’entre en jeu.
Le mécanisme mérite d’être compris, parce qu’il détermine ce qui rend une page récupérable. Le retrieval (récupération) ne procède pas par correspondance de mots-clés. Les contenus disponibles et la question posée sont convertis en représentations mathématiques, puis comparés par proximité de sens. Un passage est retenu parce qu’il traite réellement du problème formulé, et non parce qu’il emploie le même vocabulaire.
Trois conséquences éditoriales en découlent directement.
- Un contenu dont le sujet reste implicite se compare mal. La proximité de sens se calcule sur ce que le texte dit explicitement, pas sur ce que l’auteur avait en tête.
- Un passage doit pouvoir être lu seul. Ce qui est extrait est un fragment, pas la page entière, donc un paragraphe qui ne tient que par son contexte perd son sens une fois isolé.
- Le vocabulaire utile est celui de la question réelle, pas celui du secteur. Une formulation interne à un métier s’éloigne des questions que les clients posent effectivement.
Cette lecture explique aussi pourquoi une page peut être correctement indexée et rester absente des réponses. L’indexation rend le document disponible, tandis que le retrieval choisit, question par question, les passages qui méritent d’être lus.
Quelques jours: observer l’accès, pas la performance
Les premiers jours après publication servent surtout à vérifier le fonctionnement du dispositif.
La nouvelle URL figure-t-elle dans les surfaces de découverte prévues ? Les liens internes fonctionnent-ils ? Le canonical est-il correct ? Les crawlers autorisés peuvent-ils accéder à la page ? Une protection de sécurité ou une configuration robots bloque-t-elle involontairement certaines visites ?
À ce stade, une absence de trafic ou de citation possède peu de valeur diagnostique.
Pour un site d’entreprise qui ne fonctionne pas avec la fréquence de crawl d’un grand média, une période de quelques jours à deux ou trois semaines constitue un horizon raisonnable pour observer les premiers mouvements techniques.
Il s’agit d’un repère de travail, pas d’un délai promis par une plateforme.
La principale erreur consiste à réécrire trop vite. Modifier le titre, l’introduction, le maillage ou la structure quelques jours après publication peut empêcher de comprendre ensuite ce qui a réellement provoqué un changement.
Quelques semaines: examiner le voisinage dans lequel le contenu apparaît
Après plusieurs semaines, le volume devient moins intéressant que la nature des premières associations. Voici quelques questions à évaluer:
Un crawl rapide prouve un accès au contenu, et aucunement qu’un moteur ait compris de quoi la page parle.
Plusieurs mois: la persistance devient plus intéressante que le premier signal
Une nouvelle publication bénéficie nécessairement d’une période difficile à lire: nouvelle URL, nouveaux liens internes, recrawl de pages existantes, tests de classement, variations de demande et parfois changements de vocabulaire dans les requêtes.
Avec le temps, une autre question devient possible: le sujet persiste-t-il ? La page continue-t-elle à être retrouvée ? D’autres contenus du même site apparaissent-ils autour de concepts proches ? La bonne page semble-t-elle progressivement devenir la référence interne sur ce thème ? Les moteurs relient-ils le contenu à la bonne organisation, au bon service ou au bon domaine d’expertise ?
Pour structurer ce suivi, nous utilisons dans nos propres analyses de visibilité trois horizons de base:
| Période | Lecture |
|---|---|
| 30 jours | Observation: les mouvements sont encore trop récents pour être interprétés fortement |
| 90 jours | Signal: une association qui persiste commence à mériter une explication |
| 180 jours | Tendance stratégique: la persistance ou la dérive peut commencer à justifier une décision structurelle |
Source: méthode d’observation E-GRAPHICS issue de nos propres analyses de visibilité. Ces horizons sont des repères opérationnels et ne constituent pas des délais garantis par Google, OpenAI ou un autre moteur.
Cette distinction empêche de demander à une observation de trente jours de répondre à une question qui relève d’une trajectoire de six mois.
Tester les moteurs IA demande de tester le sujet, pas seulement le nom de l’entreprise
La visibilité dans un moteur classique peut être observée à travers des données relativement structurées: URL, impressions, requêtes, clics, positions.
Les moteurs de réponse ne fournissent pas nécessairement le même type de télémétrie.
Tester d’abord les réponses à ces typologies de questions: « Que sais-tu de cette entreprise ? Ou personne ? Ou procédure ? ». Les réponses donnent donc une information limitée d’abord.
Mais une analyse plus utile procède par niveaux.
Pour une entreprise ayant publié un travail approfondi sur la réduction de la friction commerciale, on pourrait par exemple tester: « Quels facteurs dégradent la conversion d’un parcours B2B malgré une augmentation du trafic ? » puis enchaîner avec: « Existe-t-il des analyses détaillées sur la relation entre friction du parcours, confiance et qualité de conversion ? » et seulement ensuite: « Quelles entreprises ou quels spécialistes ont publié une analyse approfondie de ce problème ? »
Cet exemple est très intéressant. La première question teste le concept. La deuxième teste la capacité à retrouver des documents pertinents. La troisième teste la capacité du moteur à relier ces documents à une entité identifiable.
Une visibilité réellement intéressante apparaît lorsque les trois niveaux commencent à converger.
Tester le nom de l’entreprise mesure une notoriété. Tester le problème que l’entreprise résout mesure une position éditoriale.
Une citation ponctuelle ne suffit pas à valider un positionnement
Une citation (attribution) dans ChatGPT, Perplexity ou un autre système constitue un signal utile. Elle doit rester proportionnée à ce qu’elle démontre.
Les réponses sont dynamiques. Elles peuvent varier avec la formulation de la question, les sources accessibles, le contexte, la localisation, les capacités de recherche activées et le moment du test.
Une citation isolée prouve donc surtout qu’un document a été récupéré et retenu dans un contexte particulier.
Le mécanisme d’attribution précise cette limite. Le système conserve la trace des fragments sélectionnés pendant le retrieval (récupération), puis rattache ces fragments aux phrases qu’il produit et les affiche sous forme de notes ou de liens. Une citation (attribution) atteste donc qu’un passage a servi à formuler une affirmation. Elle n’atteste ni que la page a été lue en entier, ni que l’organisation a été reconnue comme référence sur le sujet.
Cette fonction existe d’abord pour le lecteur. Elle lui permet de vérifier une affirmation à sa source et de repérer les énoncés inventés, ce que le vocabulaire technique appelle des hallucinations. Pour l’entreprise citée, la visibilité obtenue est un effet secondaire d’un dispositif de vérification, ce qui explique sa volatilité d’une formulation à l’autre.
Trois propriétés rendent une page plus facilement attribuable. Une adresse canonique stable, puisqu’une source qui change d’URL casse le lien affiché. Une organisation ou un auteur identifiable, puisque l’attribution nomme une origine. Et des passages délimités, puisque le fragment cité doit pouvoir être isolé sans perdre son sens.
La tendance devient plus intéressante lorsqu’elle se répète:
- sur plusieurs formulations réellement différentes ;
- sur plusieurs périodes ;
- sur plusieurs moteurs ;
- avec une source canonique stable ;
- et surtout avec une compréhension correcte du rôle de l’entreprise.
Cette dernière condition est essentielle.
Une entreprise peut être abondamment citée et néanmoins être mal classée dans l’esprit du moteur d’intelligence artificielle. Une société de conseil MarTech régulièrement décrite comme « agence SEO » bénéficie d’une visibilité réelle, mais son problème de positionnement reste entier.
La présence doit donc être analysée avec la qualité de l’association. Dans nos interventions, nous analysons cette qualité avant le volume: une entreprise citée sous une mauvaise catégorie gagne du trafic et perd du positionnement.
Une citation isolée documente un instant; mais une association d’information qui se répète documente une position sur le marché.
Le maillage interne aide surtout à donner un contexte au contenu
Un article isolé peut appartenir à plusieurs univers.
Par exemple, une publication sur la vitesse d’un site peut relever de l’hébergement, du développement, de l’expérience utilisateur, du référencement ou de la conversion. Un texte sur l’IA peut parler de productivité, de gouvernance, de technologie, de recherche ou de communication.
Les relations internes donnent au moteur davantage de contexte pour interpréter le rôle du document dans le corpus.
Google recommande d’ailleurs des liens HTML explorables pour faciliter la découverte des pages. Leur fonction ne se limite cependant pas à faciliter le crawl. Ainsi, un lien vers une page de service, un contenu de référence ou une preuve donne aussi une indication éditoriale: ce texte appartient à ce sujet, soutient cette proposition ou explique cette conséquence.
C’est pourquoi quelques relations contextuelles cohérentes apportent généralement davantage qu’une multiplication de liens ajoutés simplement parce qu’une nouvelle URL vient d’être publiée.
Quand faut-il réellement intervenir ?
L’absence de signal précoce crée facilement une impression d’échec.
Dans la pratique, les choses se passent différemment, et sans attendre que le retour des moteurs de recherche soit correctement interprété. Ainsi, après quelques jours, le titre est modifié. Deux semaines plus tard, de nouveaux mots sont ajoutés. Puis l’introduction est réécrite parce qu’aucun moteur IA n’a encore cité la page. L’accumulation de ces corrections empêche ensuite de savoir quelle version du dispositif a réellement été observée.
Une intervention rapide se justifie surtout lorsqu’un défaut technique est identifiable, comme dans les situations suivantes:
- URL bloquée ou inaccessible ;
- lien canonical incorrect ;
- erreur dans le sitemap ;
- directive robots involontaire ;
- liens internes cassés ;
- contenu publié différent de la version validée.
Une intervention éditoriale demande davantage de persistance:
- la page apparaît durablement dans le mauvais voisinage thématique ;
- une autre URL du site reçoit systématiquement les requêtes qui auraient dû conduire vers elle ;
- le positionnement reconstruit par plusieurs moteurs reste incohérent ;
- le service, les contenus éditoriaux et les preuves ne semblent pas appartenir au même ensemble ;
- la visibilité augmente sur un territoire commercialement indésirable.
Dans ces cas, la patience ne corrige plus rien. Le sujet relève désormais de l’architecture de visibilité.
Réécrire une page avant le premier signal interprétable supprime la mesure au lieu de corriger le résultat.
Une chronologie utile pour piloter une nouvelle publication
| Après publication | Ce qu’il est raisonnable d’observer | Ce qu’il est encore prématuré de conclure |
|---|---|---|
| J+3 à J+21 | Découverte, crawl, accessibilité, recrawl de certaines pages reliées | Succès ou échec éditorial |
| Semaine 3 à 8 | Premières impressions, requêtes et associations thématiques | Positionnement durable |
| Mois 2 à 4 | Persistance de certains concepts, retrieval ponctuel par des moteurs de réponse | Autorité acquise |
| Mois 3 à 6 | Répétition des associations, convergence entre plusieurs surfaces ou moteurs | Causalité certaine entre une modification et le résultat observé |
| Après 6 mois | Place plus stable du contenu dans le corpus et éventuelles dérives persistantes | Immobilité: le corpus continue d’évoluer |
Source: repères opérationnels E-GRAPHICS issus de nos observations et de nos travaux de visibilité, mis en perspective avec la documentation publique des moteurs. Ces délais servent au pilotage et non à promettre un résultat.
Cette chronologie empêche surtout une erreur de gouvernance: demander à un signal précoce de répondre à une question stratégique.
La visibilité utile commence lorsque la bonne association se répète
Une nouvelle page n’a pas besoin de générer immédiatement un volume important pour jouer son rôle. Elle peut clarifier un sujet, renforcer un ensemble de contenus existants, apporter une preuve, donner une source exploitable à un moteur de réponse ou permettre à une entreprise d’être correctement associée à un problème précis.
La valeur apparaît lorsque plusieurs éléments commencent à converger: accessibilité technique, sujet intelligible, relations internes cohérentes, identité claire, retrieval sur les bonnes questions et répétition de cette association dans le temps.
Les deux mécanismes ne demandent pourtant pas le même travail éditorial, et les confondre conduit à optimiser la mauvaise chose.
| Objectif | Ce que le dispositif exige | Ce qui le fait échouer en pratique |
|---|---|---|
| Être récupérable | Un sujet explicite, un vocabulaire proche des questions réelles, des passages qui se lisent seuls | Un texte allusif, un titre créatif, un raisonnement qui ne tient que sur la page entière |
| Être citable | Une adresse canonique stable, une organisation ou un auteur identifiable, des affirmations délimitées et vérifiables | Des URL qui changent, une paternité floue, des affirmations générales que rien ne permet de rattacher |
Une page peut ainsi être récupérée régulièrement sans être citée une seule fois, parce qu’elle répond au sujet sans offrir de point d’ancrage attribuable. L’inverse existe aussi, plus rarement: une source très identifiable qui traite le sujet de trop loin pour être sélectionnée.
Un crawler peut découvrir une page en quelques jours.
Les premières associations peuvent apparaître quelques semaines plus tard.
Comprendre si cette page améliore réellement la présence numérique de l’entreprise demande davantage de recul.
La différence entre ces trois temporalités devrait déterminer le rythme des décisions éditoriales.
Ce qu’il faut retenir
Une publication ne produit pas une visibilité, elle ouvre une surface que plusieurs systèmes vont traiter séparément. Le crawl atteste un accès. L’indexation atteste une prise en compte. Le retrieval atteste qu’un passage a été jugé proche d’une question. La citation, quant à elle, atteste qu’à un instant donné, pour une formulation donnée, ce passage a été rattaché à une affirmation. Confondre ces quatre attestations conduit à lire un succès ou un échec là où aucune des deux lectures n’est encore disponible.
La conséquence opérationnelle porte sur le rythme des décisions. Une équipe qui réécrit un titre à J+5 supprime la seule chose que les jours suivants auraient pu lui apprendre, puis recommence, jusqu’à ne plus savoir quelle version du dispositif a réellement été observée. La patience joue ici le rôle d’une condition de mesure, pas celui d’une vertu éditoriale.
Deux interventions restent légitimes tôt. Un défaut technique identifiable se corrige immédiatement: URL bloquée, canonical erroné, sitemap incomplet, directive robots involontaire. Une dérive éditoriale se corrige seulement quand elle persiste, parce qu’une dérive observée une fois peut rester un simple test de classement.
Nous recommandons donc de séparer explicitement les trois horizons dans le pilotage: trente jours pour l’accès, quatre-vingt-dix jours pour le signal, cent quatre-vingts jours pour la tendance. Notre expérience montre que cette séparation suffit à éviter la majorité des réécritures précoces, sans exiger d’outillage supplémentaire.
Reste une exigence plus difficile à tenir. Accepter qu’une page correcte puisse ne rien produire pendant huit semaines demande de résister à la demande de résultat, y compris lorsque celle-ci est légitime. Une mesure honnête suppose de laisser au dispositif le temps de devenir lisible.
Liens:
- AuthorityGrid Suite (un outil MarTech qui peut vérifier que le domaine, les profils publics et le balisage décrivent la même entité avant d’attendre une citation) https://labs.consultingteam.solutions/authoritygrid/
- UserFlow360 (observer ce que fait réellement le trafic entrant une fois la page trouvée) https://labs.consultingteam.solutions/userflow360-session-replay/
- Expertises E-GRAPHICS (le cadre dans lequel s’inscrit ce suivi de publication)
Mots-clés: délai d’indexation, crawl et découverte, retrieval, citation par moteur IA, ChatGPT Search, GEO, visibilité sémantique, Search Console, architecture de contenu, pilotage éditorial, Suisse romande
Sources et références
- Google Search Central, demander à Google de réexplorer une URL
- Google Search Central, diagnostic des problèmes d’exploration
- OpenAI, FAQ pour les éditeurs et développeurs
Note méthodologique: les horizons de 30, 90 et 180 jours ainsi que les fenêtres opérationnelles indiquées dans cet article proviennent des propres analyses et observations E-GRAPHICS. Ils servent à structurer le suivi et ne constituent pas des délais garantis par Google, OpenAI ou un autre moteur.
E-GRAPHICS SWITZERLAND est une agence-conseil suisse spécialisée dans la visibilité numérique, le positionnement, l’identité de marque, l’expérience utilisateur et les architectures MarTech. Elle accompagne les entreprises dans la transformation de leur présence numérique en supports de confiance, de lisibilité commerciale et de performance mesurable.
Avec la division E-GRAPHICS CONSULTING, vous comprenez pas seulement le marketing, mais aussi le côté business. Ainsi, votre communication marketing bénéficie de ce qui se fait le mieux sur l’aspect opérationnel et stratégique.
Au service des grandes sociétés multinationales et les entreprises locales actives dans les domaines suivants: luxe, secteur santé et soins, informatique bancaire, fabrication et vente au détail, services BtoB et BtoC.